


Telset.id – Google memperluas keluarga TPU generasi kedelapan dengan menghadirkan TPU 8tx dan TPU 8i Max. TPU 8tx ditujukan untuk inference yang bersifat rahasia dan terisolasi secara hardware bagi enterprise teregulasi serta pemerintah, sementara TPU 8i Max menggabungkan dua chip 8i dalam satu paket untuk kebutuhan pekerjaan agentic dengan konteks panjang. Keduanya kini tercatat berstatus “coming soon” di halaman Cloud TPU Google.
Langkah ini menyusul pengumuman April lalu, ketika Google memperkenalkan TPU 8t untuk pelatihan model AI berskala besar dan TPU 8i untuk beban kerja inference general-purpose. Dengan tambahan dua sistem baru, Google memperluas pendekatan modular yang diklaim mampu menghadirkan sistem terspesialisasi “dalam hitungan bulan, bukan tahun”.
TPU 8tx dibangun di atas silikon yang sama dengan TPU 8t. Perbedaannya, chip ini mengganti host berbasis Arm Axion yang dipakai 8t dan 8i dengan CPU 5th Gen AMD EPYC, serta mengadopsi jaringan Boardfly. Google menyebut TPU 8tx dioptimalkan untuk inference yang aman dan rahasia sekaligus pelatihan berskala kecil.
Sementara itu, TPU 8i Max bukanlah inovasi yang tampak di permukaan karena pada dasarnya merupakan dua chip TPU 8i yang digabung dalam satu paket. Hasilnya adalah dua kali lipat compute teoretis, tetapi yang lebih penting, dua kali lipat silikon dapat muat dalam “rack footprint yang sudah ada”. Google mengklaim densitas compute per kaki persegi dan per watt yang lebih tinggi.
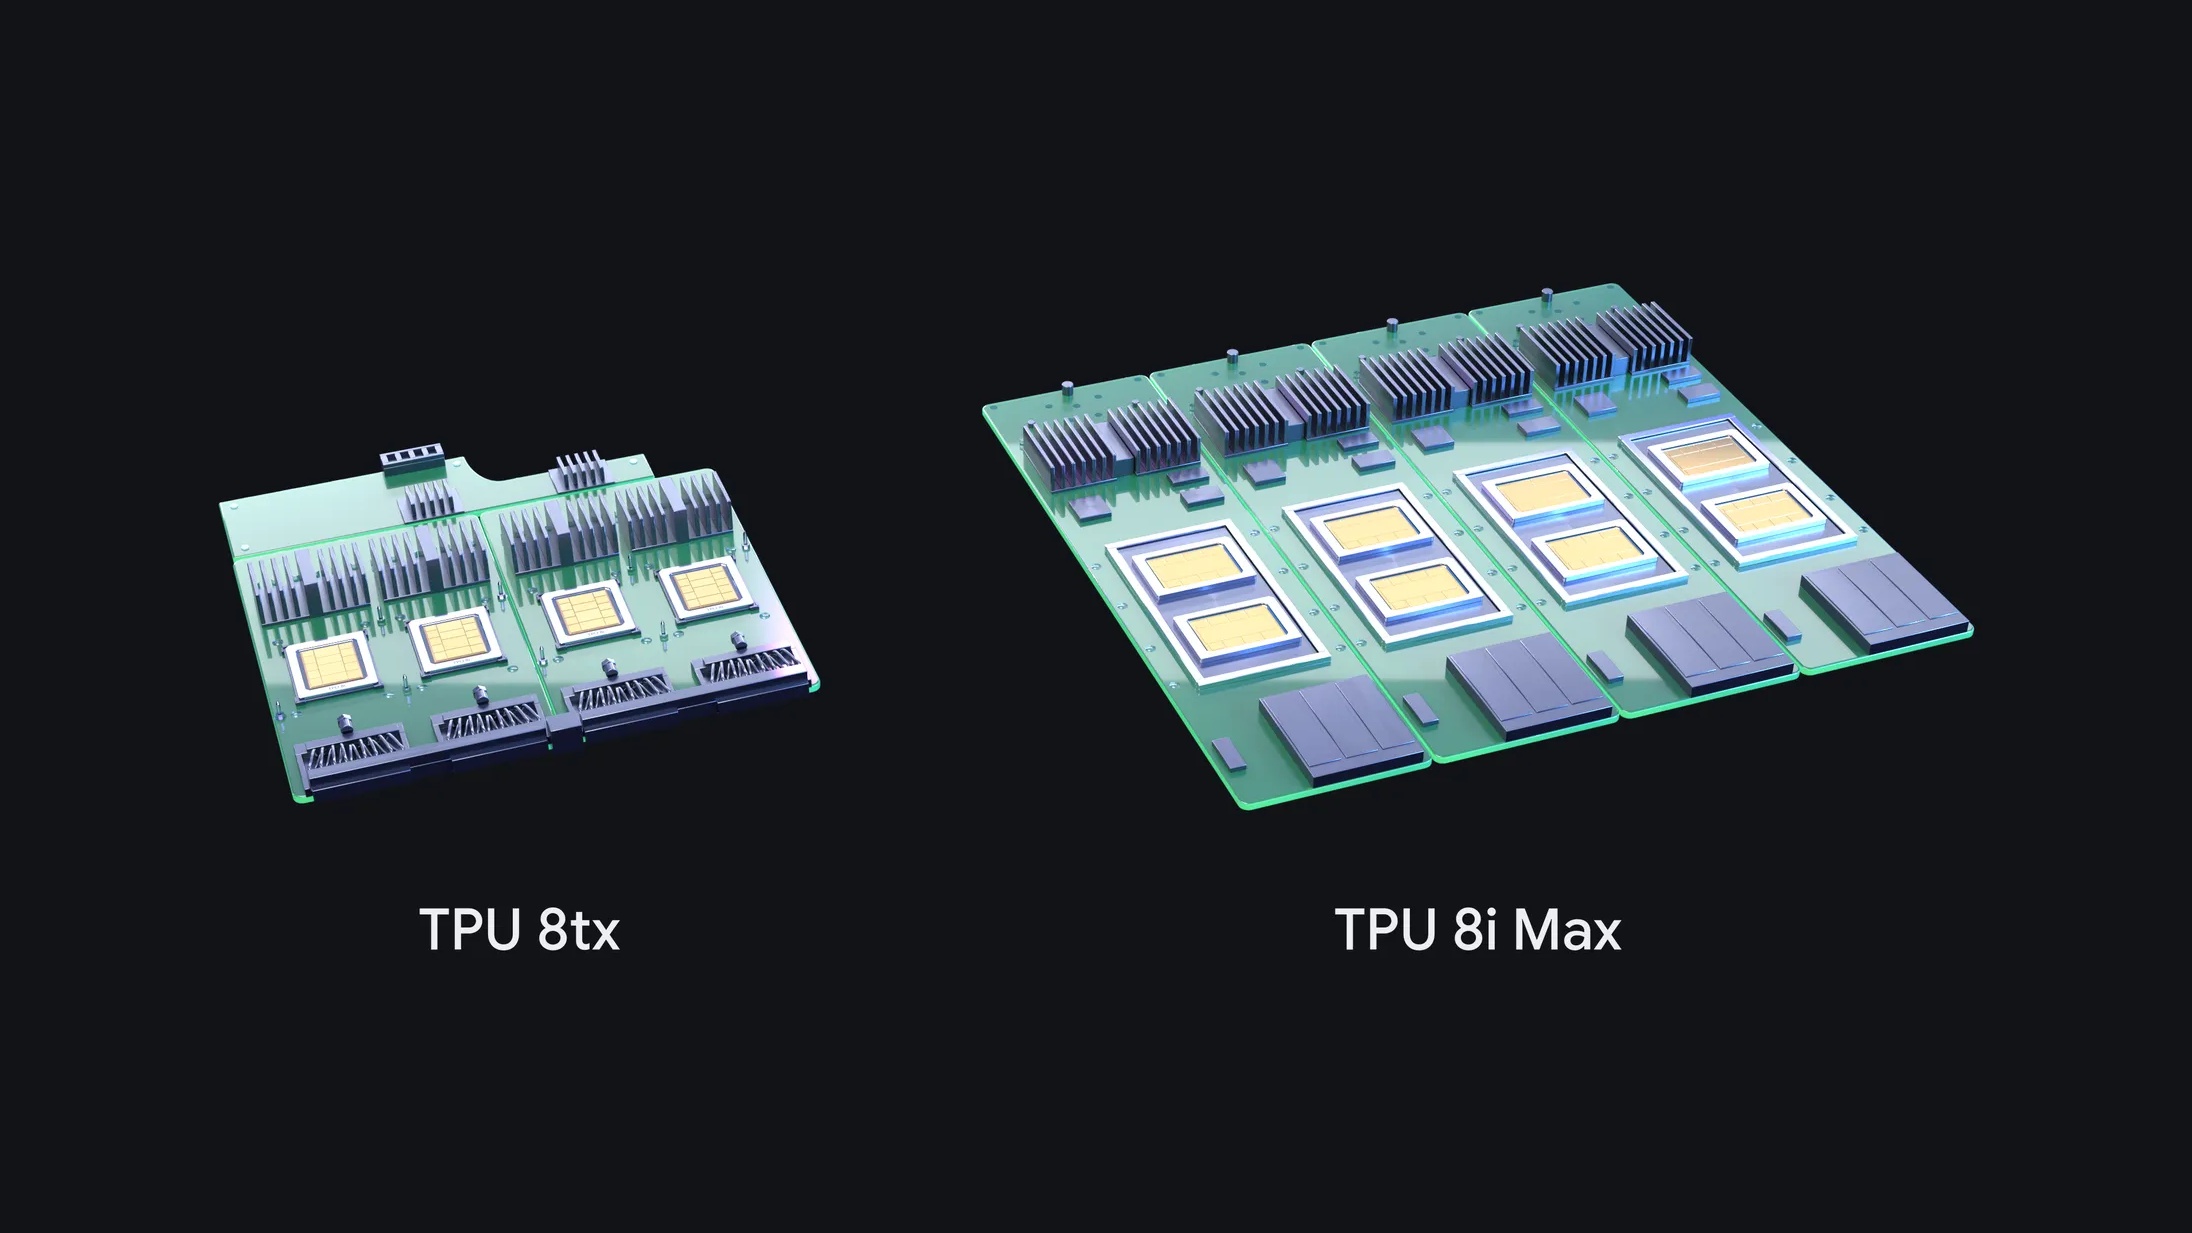
Menggandakan SRAM dan bandwidth HBM membantu pem skalaan tetap berjalan. Berdasarkan turunan angka, TPU 8i Max berada di sekitar 20,2 FP4 PFLOPS, 768 MB SRAM, dan bandwidth HBM sekitar 17,2 TB/s. Angka ini dibandingkan dengan GPU Nvidia Rubin R200 yang tertera 50 FP4 PFLOPS untuk inference dan 22 TB/s HBM4 per socket, atau AMD MI455X dengan 40 FP4 PFLOPS. Google menyebut jarak compute kian menyempit.
Penggandaan bandwidth memori juga menjadi salah satu jalan untuk menghindari perpindahan ke HBM4. Google menyebutnya sebagai memory wall, atau hambatan bandwidth, yang menjadi perhatian nyata “ketika puluhan agen AI bekerja bersama di seluruh basis kode perangkat lunak”. Context window yang lebih besar, dengan model yang menargetkan 1 juta token, berarti KV cache lebih besar yang sebagian disimpan di SRAM, dan setiap token baru harus membaca cache itu kembali dari memori. Di sinilah tambahan bandwidth HBM membantu.
Baca Juga:
Google juga menyediakan perangkat lunak pendukung agar agen dapat memaksimalkan hardware tersebut. TPU Sync adalah “model-state layer untuk klaster TPU” bersumber terbuka yang memindahkan KV cache dari HBM ke DRAM host dan, secara eksperimental, ke shared storage. Google menyebut langkah ini dapat memangkas latensi transfer KV “lebih dari 90%”, dengan keuntungan time-to-first-token yang bervariasi tergantung beban kerja. Google juga mengumumkan Agent Compute Engine, layanan Google Cloud yang menjeda sesi agen yang idle dan memindahkan memori kerjanya hingga dibutuhkan kembali.
Google mengaitkan stack vLLM-TorchTPU miliknya dengan capaian “state-of-the-art price-performance” pada InferenceX dan AgentX, yang menguji pekerjaan coding agentic dan konteks panjang secara realistis. Namun, angka pihak ketiga yang telah dipublikasikan sejauh ini baru untuk TPU Ironwood generasi sebelumnya. Dalam uji InferenceX SemiAnalysis pada September, menjalankan Qwen3.5 397B dalam FP8, Ironwood menghasilkan 50,4% lebih banyak token per dolar dibanding Nvidia B200 dan 96,0% lebih banyak dibanding B300 pada 20 token per detik per pengguna.
Satu catatan, Ironwood tidak memiliki FP4 native. Meski demikian, hasil November menunjukkan FP8 Ironwood mengalahkan FP4 GB300 NVL72 Nvidia pada model yang sama, dengan performa per dolar 1,67 kali lipat. Belum ada hasil generasi kedelapan yang bisa dibandingkan untuk melihat perbedaan generasi baru.
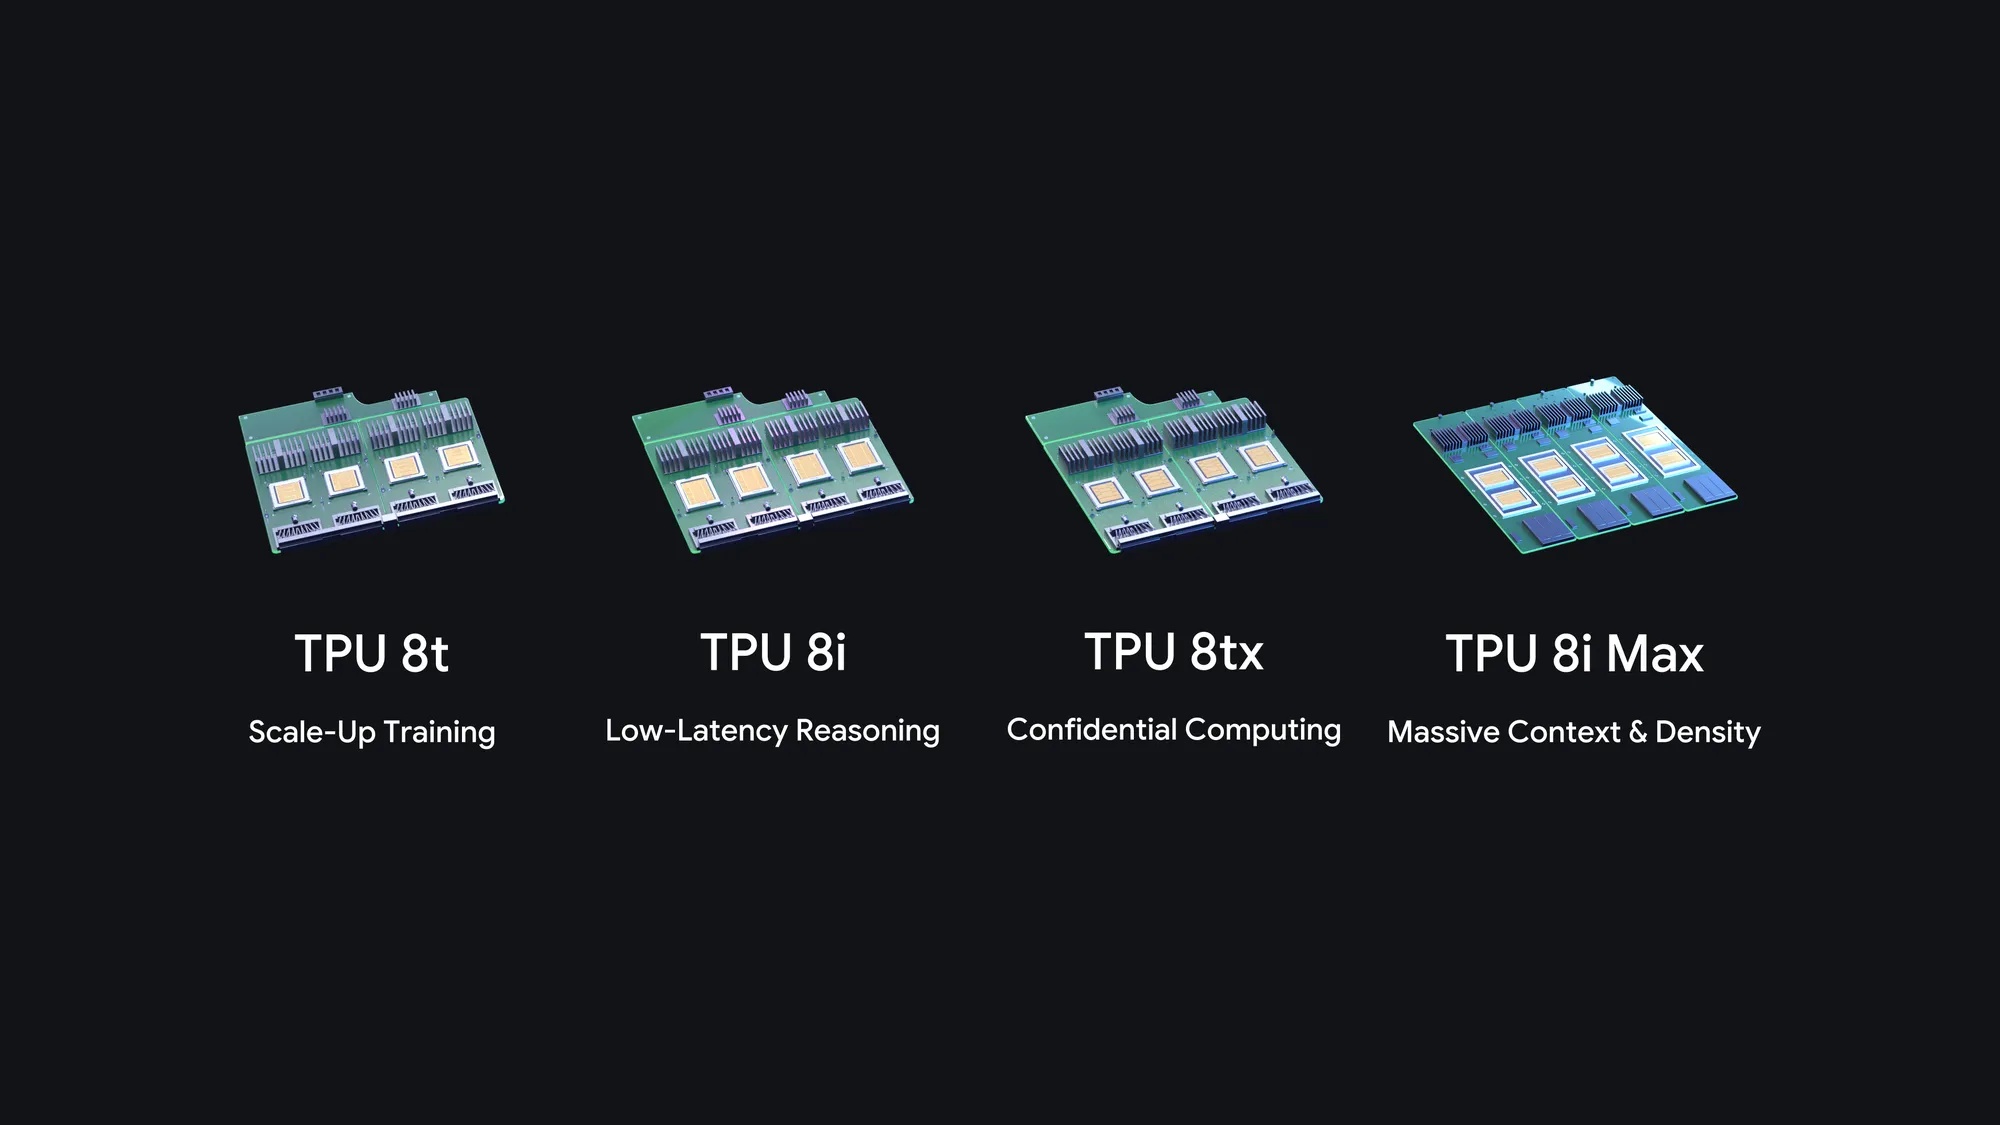
Berbeda dari 8i Max yang dirancang untuk pekerjaan konteks panjang, TPU 8tx yang “dibangun di atas silikon yang sama dengan TPU 8t” dioptimalkan untuk “inference yang aman dan rahasia” serta pelatihan skala kecil. Keamanan ditanamkan langsung di hardware dengan isolasi untuk mencegah pengintaian data sensitif, termasuk bobot model. Biasanya data harus dibuka di memori selama pemrosesan, dan langkah isolasi inilah yang ditujukan untuk menutup celah tersebut.
Chip ini diperuntukkan bagi area yang memprioritaskan keamanan dan kerahasiaan, yakni enterprise teregulasi dan pemerintah, terutama yang menggunakan model frontier atau proprietary. Dalam kasus tersebut, operator mungkin ingin “melakukan fine-tuning model menggunakan data privat mereka, melakukan distilasi model besar menjadi lebih kecil, dan melatih agen mereka” tanpa harus memindahkan data sensitif antar klaster. Agen dan keamanan bertemu di sini untuk “eksekusi agen yang aman”.
Pada April lalu, Pentagon dan Google dikabarkan sempat melakukan pembicaraan terkait penggunaan TPU di lingkungan terklasifikasi, meski chip 8tx tidak disebut secara spesifik. Private AI Compute Google, “platform TPU yang diperkeras” dengan perlindungan “sebanding dengan TEE tipikal” menurut technical brief September, sudah menjalankan serving rahasia di TPU. TPU 8tx tampak menjadi kapabilitas tersebut yang diubah menjadi produk untuk pelanggan.
Alternatifnya termasuk Nvidia NVL72, dengan satu domain keamanan melintasi 72 GPU Rubin, 36 CPU Vera, dan interkoneksinya, serta Intel TDX yang menambahkan trusted I/O untuk mencakup data yang berpindah ke akselerator.
Host TPU 8tx berbasis board 5th Gen AMD EPYC, bukan host Axion pada 8t yang menggantikan x86 pada April. Ada satu Axion untuk setiap dua TPU pada 8i, dibandingkan satu Xeon per empat pada Ironwood. Google tidak memberikan alasan perubahan ini, tetapi daftar konfigurasi Confidential VM miliknya mencantumkan chip seri AMD dan Intel, tanpa chip berbasis Arm. Private AI Compute menggunakan “hardware Trusted Execution Environment berbasis AMD” untuk beban kerja CPU, yang menunjukkan Google menukar sesuatu yang sudah dijalankannya di stack rahasia.
TPU 8tx juga mengadopsi jaringan Boardfly milik 8i alih-alih torus pada 8t. Google mengklaim jaringan ini dapat menghadirkan “latensi hingga 2x lebih rendah dibanding TPU 8t” dengan hampir tanpa penalti performa, meski tidak jelas ukuran apa yang digunakan. Jaringan torus alternatif cocok untuk pelatihan karena chip sebagian besar bertukar data dengan tetangga secara terprediksi, tetapi inference pada model mixture-of-experts dan reasoning berskala besar dapat mengirim pesan lebih kecil antar chip yang berjauhan, dengan setiap hop menambah delay. Dengan Boardfly, maksimal tujuh hop dibandingkan 16 hop pada 1.024 chip.
Yang masih kurang adalah tabel spesifikasi lengkap, jumlah kapasitas HBM, ukuran pod, tanggal ketersediaan, harga, dan pelanggan untuk kedua sistem. Detail attestation, yakni kemampuan pelanggan memverifikasi kerahasiaan, juga belum tersedia untuk 8tx. TPU 8tx dan 8i Max saat ini tercatat bersama 8i dan 8t sebagai “coming soon” di halaman Cloud TPU Google.
Menghadirkan dua sistem TPU baru hampir tujuh bulan setelah pasangan April menunjukkan Google ingin memproduksi sistem terspesialisasi jauh lebih cepat dibanding sebelumnya. Kini tinggal pembuktian melalui benchmark dan tanggal ketersediaan saat hardware benar-benar berada di tangan pelanggan. Bagi pelaku industri yang mengikuti arah adopsi AI, langkah Google ini menjadi sinyal bahwa persaingan akselerator AI tidak lagi hanya soal compute mentah, tetapi juga keamanan, bandwidth memori, dan efisiensi per watt. Informasi lebih lanjut seputar ekosistem Google dapat dibaca melalui Google Wallet dan Google Health.


Komentar
Belum ada komentar.