


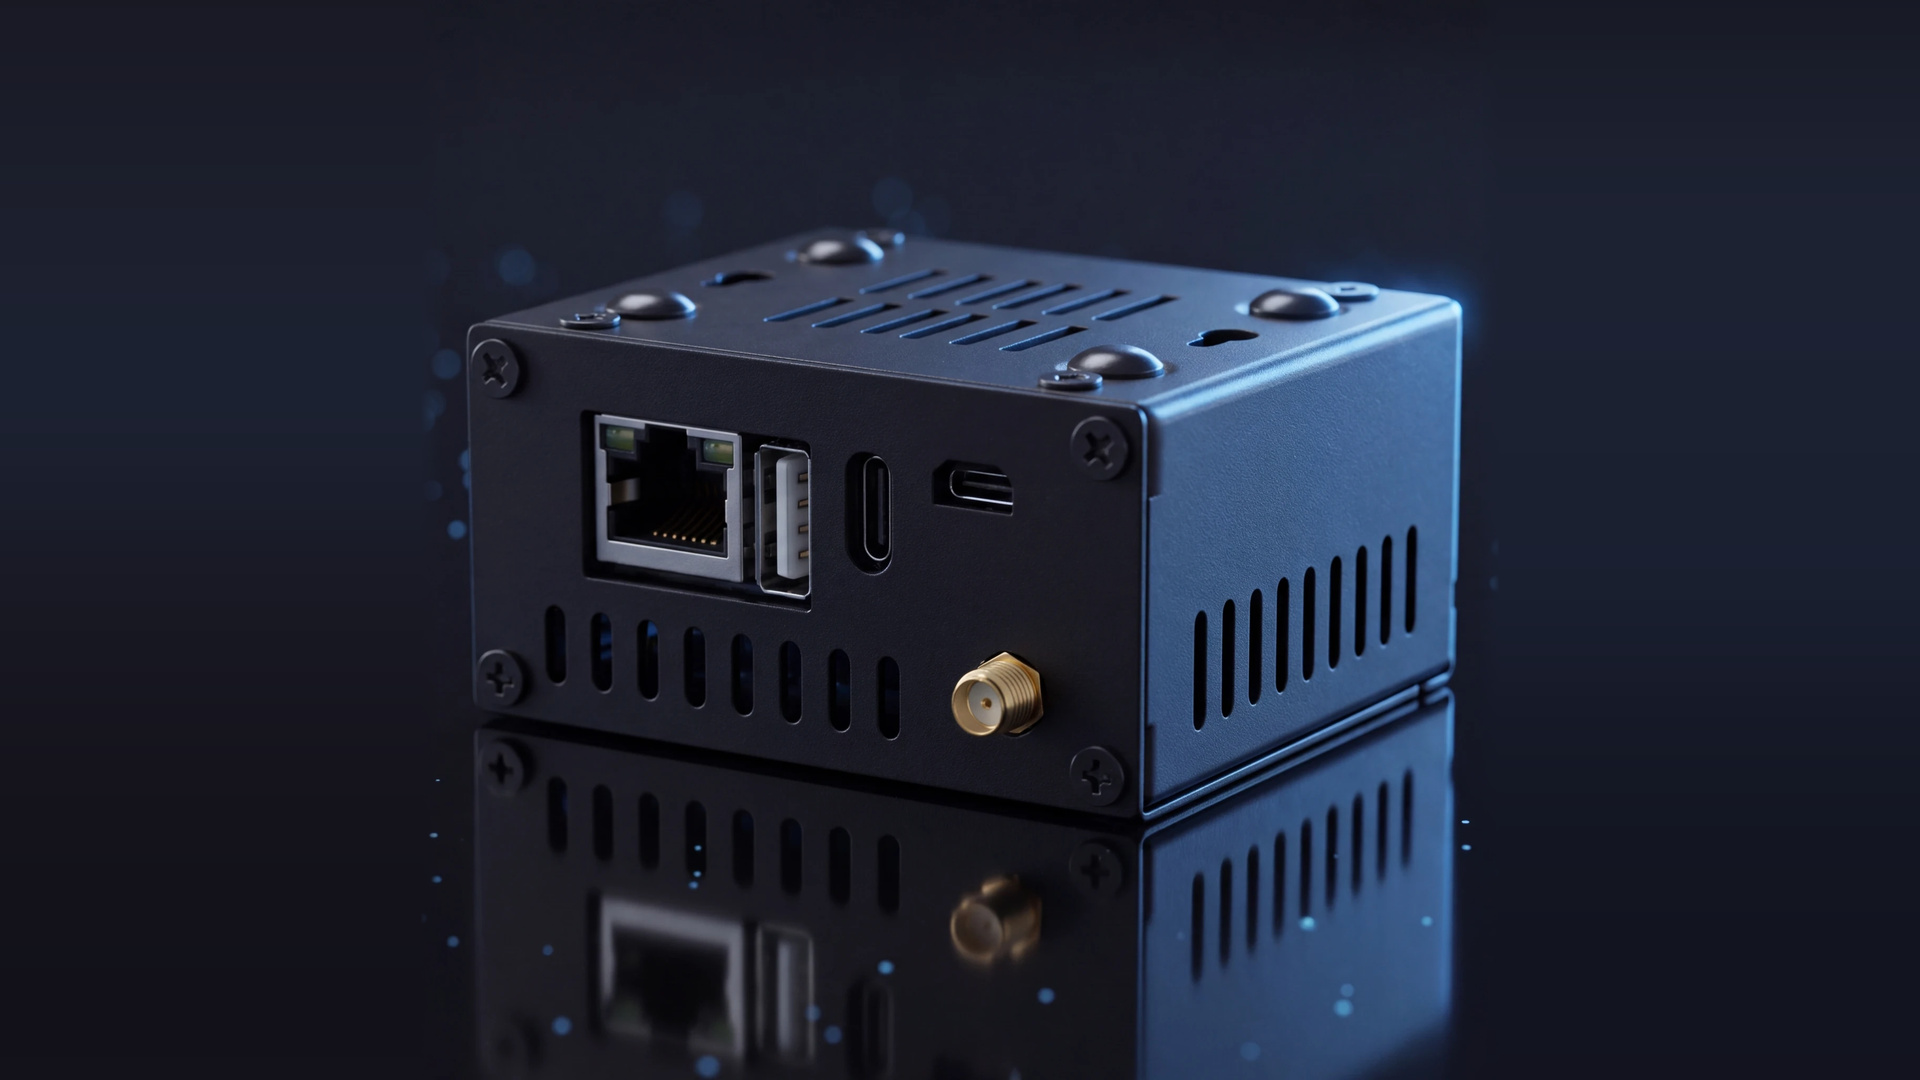
Telset.id – Di tengah lonjakan harga DDR5 yang disebut mencapai 486% dari harga Juli 2025 pada pertengahan Agustus, TradeMAV menawarkan RAMDeck sebagai jalan lain untuk menjalankan model AI besar di rumah: bukan membeli RAM lebih banyak, melainkan meminjam memori yang sudah ada di perangkat lain. Hub kecil berdaya rendah ini sedang melakukan crowdfunding di Indiegogo dan terdaftar seharga $109 untuk early backer, dengan kampanye fixed funding terhadap target $10.000 yang ditutup pada 8 November 2026.
Gagasan RAMDeck adalah menghubungkan Windows PC, Mac, Linux, dan ponsel Android dalam satu jaringan rumah menjadi satu kumpulan memori, sehingga model yang terlalu besar untuk satu perangkat bisa dipecah ke semuanya. TradeMAV mengakui bahwa tekanan harga RAM menjadi latar belakang proyek ini. Dalam cerita asal-usulnya, perusahaan menyebut kit DDR5 64GB naik dari sekitar $191 pada Agustus 2025 menjadi $1.118 setahun kemudian.
Data ritel Jerman dari 3DCenter yang dikutip menunjukkan DDR5 berada di 486% dari harga Juli 2025 pada pertengahan Agustus. Samsung telah memberi tahu analis bahwa kelangkaan akan bertahan hingga 2028, sementara chairman SK Group memperingatkan kondisi ini bisa berlangsung hingga 2030. Angka-angka itu menjelaskan mengapa pendekatan RAMDeck mendapat perhatian, meski secara teknis bukan hal baru.
Cara Kerja RAMDeck dan Mesin di Belakangnya
Yang dilakukan RAMDeck sebenarnya tidak seheboh istilah “pooling RAM”. Tidak ada memori yang digabung di level hardware. Lapisan model dibagi ke sejumlah mesin, masing-masing menyimpan bagiannya di memori lokal, dan hanya hasil antara yang melintas di jaringan saat setiap token dihasilkan.
Repositori GitHub publik TradeMAV cukup terbuka soal jalur teknisnya. Node agent menjalankan server ggml RPC milik llama.cpp di setiap perangkat yang berkontribusi; README-nya menyebut koordinator kompatibel mana pun dapat mengendalikannya lewat protokol standar llama.cpp RPC, dan cara yang disarankan untuk memastikan semuanya berjalan adalah perintah llama-cli standar. Kontribusi TradeMAV ada pada orkestrasi di sekelilingnya: penemuan otomatis, penempatan lapisan yang mengisi GPU cepat lebih dulu sebelum RAM sistem yang lebih lambat, pemulihan kegagalan, dashboard, dan API yang kompatibel dengan OpenAI.
Namun komponen hub itu sendiri minim detail. Tidak ada halaman TradeMAV yang mencantumkan prosesor, memori, port, atau konsumsi dayanya. Panduan pooling mereka sendiri mengakui bahwa jika Anda nyaman dengan skrip terminal, “rute DIY open-source gratis adalah pilihan ideal”. Pooling perangkat untuk inferensi juga bukan hal baru; exo milik Exo Labs yang open source sudah menawarkan penemuan perangkat otomatis dan API drop-in lintas komputer, ponsel, dan single-board computer sejak setidaknya awal 2025. Di kelas premium, Mac Studio M5 Ultra baru dari Apple mendukung clustering lewat Thunderbolt 5 dengan RDMA, dan Apple mengklaim empat mesin menghasilkan kecepatan inferensi hingga tiga kali lipat dari satu mesin.
Baca Juga:
Keunggulan pembeda RAMDeck adalah cakupannya. FAQ-nya menjanjikan desktop Windows CUDA, Mac Apple Silicon, Mac Intel lama, mesin Linux, dan ponsel Android dalam satu klaster, sesuatu yang dimungkinkan oleh campuran backend llama.cpp. Soal performa, TradeMAV justru terus terang. Halaman ceritanya memperingatkan bahwa “memori yang dikumpulkan menukar kecepatan dengan kapasitas”, dan tulisan benchmark-nya menyarankan pembaca yang mengejar performa mentah untuk membeli GPU dengan VRAM lebih tinggi.
Hasil benchmark andalannya bertumpu pada mini PC Beelink dengan RTX 3060 dan model mixture-of-experts yang hanya mengaktifkan sekitar 3 miliar parameter per token: 39 token per detik untuk Qwen3-Coder 30B di mini PC dan sebuah M4 Mac mini, serta 16 token per detik untuk varian REAP 40B dari Qwen3-Coder-Next. Model 7B yang mencapai 43 token per detik, menurut penjelasan TradeMAV sendiri, berjalan di RTX 3060 tersebut.
Model dense bercerita lain. Model dense 27B hanya mencapai 1,92 token per detik di empat perangkat, dan gpt-oss-120b dari OpenAI berjalan 1,37 token per detik pada klaster enam perangkat. Model 120B pada konfigurasi lima mesin berbeda mencapai 3,1 token per detik setelah membutuhkan sekitar tujuh menit untuk inisialisasi. Angka itu memang lebih baik daripada crash kehabisan memori, yang menjadi inti pitch TradeMAV, tetapi sangat lambat.
Bukan Barang Baru, tapi soal Kenyamanan
Mengumpulkan perangkat untuk inferensi sudah menjadi pendekatan yang dikenal. Exo Labs lewat exo open source menawarkan penemuan perangkat otomatis dan API drop-in sejak awal 2025. Apple dengan Mac Studio M5 Ultra mendorong sisi premium lewat clustering Thunderbolt 5 dan RDMA. Di sisi lain, llama.cpp RPC mode dan exo bisa dicoba gratis lebih dulu oleh para tinkerer.
Bagi pengguna yang tidak ingin menyentuh terminal, $109 di Indiegogo membeli kenyamanan berupa orkestrasi, dashboard, dan API kompatibel OpenAI. Namun perlu dicatat, seperti halnya hardware hasil crowdfunding, uang itu membeli janji, bukan produk jadi. TradeMAV sendiri belum mengungkap spesifikasi hub, dan kampanye fixed funding terhadap target $10.000 menunjukkan proyek ini masih berada di tahap awal.
Konteks pasar RAM yang sedang panas membuat narasi RAMDeck mudah diterima. Harga DDR5 yang melonjak, peringatan Samsung soal kelangkaan hingga 2028, dan sinyal SK Group hingga 2030 menjadi alasan mengapa sebagian pengguna mungkin tergoda mencoba jalur pooling. Namun TradeMAV tidak menyembunyikan bahwa pendekatan ini menukar kecepatan dengan kapasitas, dan bagi pengguna yang menginginkan performa tinggi, GPU dengan VRAM lebih besar tetap menjadi saran perusahaan itu sendiri.
Untuk konteks industri, dinamika open source dan komunitas teknologi juga menjadi sorotan, seperti yang terlihat dalam kasus proyek berbasis AI di komunitas r/opensource. Sementara di sisi infrastruktur, gangguan layanan besar seperti yang menimpa Wikipedia dan situs pemerintah menjadi pengingat bahwa ketergantungan pada sistem terpusat pun punya risiko.
Secara ringkas, mesin RAMDeck membungkus perangkat lunak gratis, spesifikasi hub-nya belum diungkap, dan sejumlah angka yang dipublikasikan menunjukkan keterbatasan saat pendekatan ini diterapkan. Bagi para tinkerer, llama.cpp RPC mode dan exo tidak memerlukan biaya untuk dicoba lebih dulu. Bagi yang lain, $109 membeli kenyamanan sekaligus, sebagaimana lazimnya hardware hasil crowdfunding, sebuah janji yang belum tentu terwujud.
[Disclaimer: Kami tidak merekomendasikan atau mendukung proyek crowdfunding mana pun. Semua kampanye crowdfunding memiliki risiko bawaan, termasuk kemungkinan penundaan, perubahan, atau produk tidak terkirim. Calon pendukung sebaiknya mengevaluasi detail secara cermat dan melanjutkan atas kebijakan sendiri.]


Komentar
Belum ada komentar.